Recopilación de datos de marketing y publicidad con Cloudbypass API gestionando desafíos de Cloudflare a escala
Diseñado para equipos de crecimiento y flujos de inteligencia publicitaria, Cloudbypass API te ayuda a recopilar de forma constante datos de marketing valiosos en sitios protegidos, como creatividades, estructura de landing pages, ubicaciones de canales, señales de exposición y tendencias de keywords. Gestiona automáticamente los desafíos de Cloudflare, incluido el chequeo de 5 segundos, el JS Challenge y Turnstile CAPTCHA, y soporta integración multilenguaje y solicitudes de alta concurrencia. Reduce reintentos, bloqueos y carga operativa para mantener datasets más completos, en tiempo real y accionables.
Prueba gratis Documentación API Generador de código
¿Por qué es tan difícil la recopilación de datos de marketing y publicidad?
4 puntos de dolor comunes en la recopilación de datos de marketing y publicidad
Las plataformas de anuncios y los sitios de medios aplican protección anti-bot y anti-automation protection, pasos de verificación frecuentes y estructuras de página que cambian a menudo. Los flujos de extracción de datos suelen fallar en la verificación o quedar bloqueados, lo que provoca datos faltantes, retrasos y baja reproducibilidad. Esto reduce la eficiencia del análisis de rendimiento y la optimización de campañas.
-
La verificación de Cloudflare bloquea las solicitudes de recopilación
Los desafíos de Cloudflare pueden impedir el acceso al HTML y romper el web scraping automatizado.
-
Creatividades dinámicas y landing pages difíciles de capturar
El contenido depende de scripts y APIs asíncronas, por lo que las solicitudes directas pueden devolver resultados incompletos o vacíos.
-
La alta concurrencia activa controles de riesgo y bloqueos
Al aumentar el volumen, entra en juego el límites de solicitudes: las IPs y sesiones caducan rápido y la success rate cae.
-
Datos inconsistentes dificultan la validación cruzada
La misma página puede devolver versiones distintas, generando extracción inestable y monitoreo y backtesting poco confiables.
Contacto de soporte técnico
De “carga” a “extracción de datos fiable y repetible” con Cloudbypass API
Cloudbypass API reúne gestión de verificaciones, persistencia de sesión y simulación de solicitudes tipo humano en una interfaz simple. Devuelve HTML limpio y utilizable, ideal para web scraping de marketing de alta frecuencia, extracción masiva de datos y monitoreo continuo.
-
Gestión automática de desafíos anti-bot
Gestiona de forma consistente los chequeos de 5 segundos de Cloudflare, los desafíos JavaScript y los flujos de Turnstile, sin lógica frágil y con páginas listas para parsear.
-
Persistencia de sesión más estable
Reutiliza sesiones validadas y las renueva automáticamente tras superar desafíos, reduciendo costos de verificación. Ideal para seguimiento continuo de anuncios, landing pages y cambios de campaña.
-
Soporte de scraping de alta concurrencia
Diseñado para scraping paralelo a gran escala, reduce reintentos y timeouts y mantiene la recolección de inteligencia de marketing continua y consistente.
-
Control total de huellas y parámetros
Configura User-Agent, Referer y comportamiento headless para imitar mejor el tráfico real y reducir el riesgo de activar detección de bots o protección anti-scraping.
Casos de uso
Creado para la extracción de datos de marketing y publicidad, especialmente cuando necesitas gestionar verificaciones de Cloudflare y otros sistemas para un web scraping estable y escalable
Monitoreo de creatividades publicitarias de competidores
Sigue ciclos de actualización por canal, región y ventana temporal. Crea datasets de creatividades más rápido, detecta patrones de alta frecuencia y decide iteraciones con señales más claras.
Snapshots y versionado de landing pages
Captura snapshots versionados para registrar módulos, jerarquía de copy y cambios en la ruta de conversión. Útil para comparativas A/B, retrospectivas y evitar huecos tras actualizaciones.
Scraping de hubs de campaña y exposición
Extrae páginas de entrada, secciones destacadas y listados agregados para medir cadencia, cambios de placement y rotación de creatividades, ideal para picos estacionales y campañas cortas.
Rankings de keywords y seguimiento SEO
Recoge SERPs y tendencias para construir curvas de ranking e historial de visibilidad. Úsalo para ampliar keywords PPC, optimizar contenidos y analizar el crecimiento de competidores.
Scraping en sitios con alta protección
Para medios y sitios con defensas Cloudflare más estrictas, Cloudbypass API ayuda a recuperar HTML de forma fiable y mantener un pipeline de scraping disponible, reduciendo pérdidas y retrasos por bloqueos.
Monitoreo de alta frecuencia y actualizaciones masivas
Pensado para actualizaciones por hora o por minuto. Automatiza tus flujos con monitoreo concurrente a gran escala y refresh incremental, manteniendo datasets completos y listos para comparación continua.
Flujo de integración
1. Crear cuenta
Registra una cuenta de Cloudbypass API: Registrarse ahora
Registra una cuenta de Cloudbypass Proxy: Registrarse ahora
Las cuentas son compartidas. Registra una sola y, en 30 días, entra al panel y haz clic en “🎁 Prueba” para recibir créditos y tráfico de prueba.
2. Generador de código
Configure y pruebe solicitudes de Cloudflare o DataDome con el generador de código. Ambos usan la misma lógica de integración y el mismo código. Mantenga la IP del proxy, las cookies y la sesión constantes.
La versión V1 incluye un pool de IP dinámicas y no requiere proxy si el acceso es correcto.
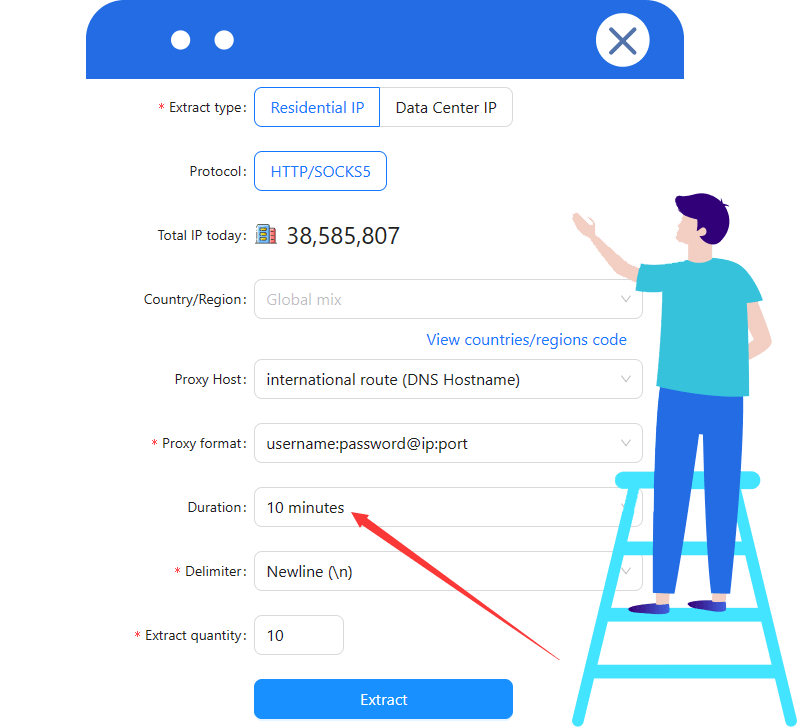
La versión V2(s) requiere IP fija o con validez temporal; para IP dinámica de Cloudbypass, configura ≥10 minutos. (ver imagen)
Para soporte técnico, revisa la documentación de la API o contacta al soporte.
3. Integrar Cloudbypass API
Integre en su aplicación el código de solicitud ya probado. Cloudflare y DataDome comparten la misma integración de API y forma de llamada. Valide el estado y el contenido antes de analizar datos, paginar o automatizar tareas.
4. Elegir plan
Una vez completadas las pruebas, elija un plan según su uso. Cloudflare y DataDome comparten los mismos créditos de API, reglas de consumo y precios. Ver precios
Para tráfico de proxy IP: 【Proxies de centro de datos dinámicos o residenciales dinámicos】
Las verificaciones de Cloudflare y DataDome consumen créditos de API; algunos flujos también requieren un proxy. Los créditos y el tráfico de proxy se facturan por separado. Un proxy no sustituye la gestión de CAPTCHA.

Precios de Cloudbypass API
Prueba la compatibilidad del sitio y elige un plan de API según tu uso
Cada solicitud correcta consume 1 crédito. Una verificación V2(s) completada consume 2 más, que no se devuelven si la respuesta posterior falla. El tráfico de proxy se factura aparte.
Plan Básico
-
$49
-
Puntos:80000Validez:30 díasParalelo:20 req/s
Plan Estándar
-
$79
-
Puntos:300000Validez:30 díasParalelo:20 req/s
Plan Avanzado
-
$129
-
Puntos:1000000Validez:30 díasParalelo:25 req/s
Plan Profesional
-
$259
-
Puntos:2200000Validez:30 díasParalelo:25 req/s
Plan Premium
-
$489
-
Puntos:4600000Validez:30 díasParalelo:30 req/s
-
Gran relación calidad-precio
Plan Enterprise
-
$1056
-
Puntos:12000000Validez:30 díasParalelo:30 req/s
Si tu volumen de scraping es mayor o necesitas un plan a medida Puntos ilimitados / Servidor dedicado / Más capacidad de concurrencia / Soporte técnico prioritario
Contactar para un plan personalizado Comprar IPs dinámicasFAQPreguntas frecuentes
¿Por qué el web scraping de datos de marketing y anuncios se bloquea tan fácil con Cloudflare?
Muchas señales de marketing y ads están en páginas de alto valor (librerías creativas, landing pages, rankings y listas). Estos endpoints reciben muchas solicitudes y patrones previsibles, lo que activa la protección de Cloudflare (JS Challenge, browser check o Turnstile CAPTCHA) y provoca respuestas vacías o fallos de carga.
¿Qué tipos de Cloudflare challenge puede gestionar Cloudbypass API?
Cloudbypass API gestiona el browser check (tipo “5-second”), el JS Challenge y también flujos protegidos por Turnstile CAPTCHA, para que tu crawler reciba HTML limpio y fácil de parsear.
Tras pasar el challenge, ¿cómo mantenemos estable un monitoreo de larga duración?
La estabilidad depende del reuso de sesión y de la validez de tokens. Tras una verificación exitosa, Cloudbypass API puede mantener la sesión y reutilizarla dentro de su ventana válida, reduciendo verificaciones repetidas y bajando la tasa de fallos.
Ejecutamos alta concurrencia: ¿cómo reducimos bloqueos y coste de reintentos?
Funciona separar el manejo del challenge, el comportamiento realista de petición y la orquestación de concurrencia en una capa de adquisición. Cloudbypass API devuelve el HTML del objetivo y soporta llamadas de alta concurrencia, reduciendo cortes y reintentos innecesarios.
Nuestras landing pages se renderizan con JS: ¿se perderá contenido clave?
Muchas landing pages dependen de scripts y APIs asíncronas, y un fetch HTTP simple puede devolver contenido incompleto. Cloudbypass API ofrece un entorno de petición tipo usuario real y controles de headers/parameters, aumentando la probabilidad de obtener contenido completo y usable.
¿Hay que reescribir el crawler para integrar Cloudbypass API?
No. Cloudbypass API ofrece un endpoint HTTPS unificado: normalmente basta con cambiar el destino de la petición y añadir los headers/query parameters requeridos. La integración es rápida en la mayoría de lenguajes y stacks.