Solución integral para scraping de noticias y ficción web con gestión fiable de verificación Cloudflare
Los portales de noticias y sitios de ficción web suelen bloquear scrapers con protección de Cloudflare, como el desafío de 5 segundos, los JS Challenge y Turnstile CAPTCHA. Cloudbypass API gestiona el flujo de verificación y devuelve el HTML original. Así puedes extraer listas de categorías, hubs temáticos, artículos completos, directorios de capítulos y feeds de actualización. Diseñado para alta concurrencia y rendimiento estable, reduce el mantenimiento y mantiene tu sincronización continua y al día.
Iniciar prueba gratis Documentación API Generador de código
Por qué el scraping de noticias y ficción web es difícil
Lo más difícil del scraping de noticias y ficción web es obtener contenido de forma consistente
Los sitios de noticias y plataformas de ficción web se actualizan con frecuencia, usan estructuras complejas y a menudo están detrás de Cloudflare. En el scraping es común ver bucles de verificación, contenido incompleto, límites de solicitudes y renderizado dinámico, lo que provoca datos perdidos y sincronización con retrasos.
-
Bloqueos frecuentes por verificación de Cloudflare
El desafío de 5 segundos, los JS Challenge y Turnstile CAPTCHA pueden activarse repetidamente y romper scripts sin aviso.
-
Difícil seguir actualizaciones de capítulos
Las listas de capítulos cambian rápido y causan actualizaciones perdidas, scraping duplicado y monitorización poco fiable a largo plazo.
-
El renderizado dinámico pierde contenido
La carga asíncrona y la paginación pueden devolver HTML vacío o parcial, complicando el parsing estructurado.
-
La alta concurrencia activa reglas anti-bot
Los picos de tráfico pueden causar throttling y bloqueos, con tasas de éxito inestables y rendimiento impredecible.
Contacto de soporte técnico
Pipeline fiable para scraping de noticias y ficción web con Cloudbypass API
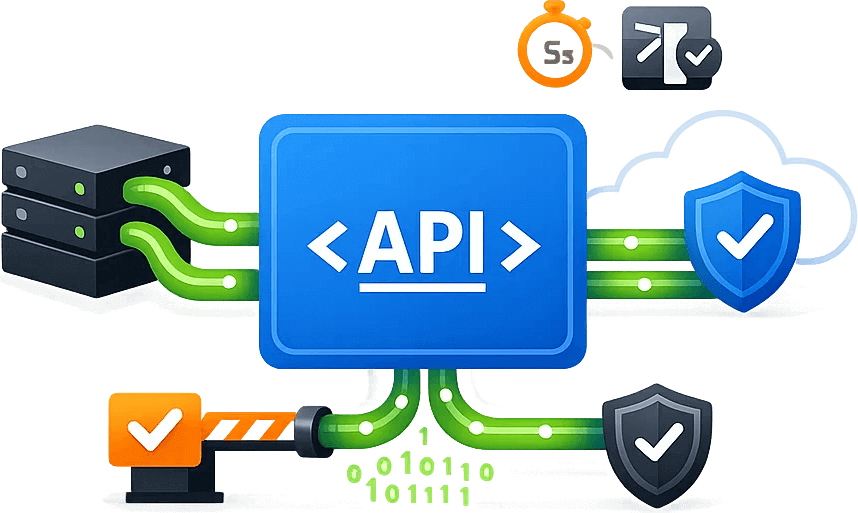
Cloudbypass API está diseñado para web scraping y extracción de contenido a gran escala, con soporte para gestionar verificaciones de Cloudflare. Maneja automáticamente el browser check, el JS Challenge y Turnstile CAPTCHA, reduciendo trabajo manual y costes de mantenimiento. Con alta concurrencia, tus flujos de rastreo, parsing y sincronización se mantienen estables.
-
Browser check automático (5 segundos)
Evita la lógica del challenge. Accede a páginas protegidas y obtén el HTML original para mejorar la tasa de éxito.
-
Soporte completo para Cloudflare JS Challenge
Gestiona verificaciones JavaScript y redirecciones, reduciendo ajustes de scripts y mantenimiento continuo.
-
Scraping compatible con Turnstile
Funciona con Turnstile y otros escenarios anti-bot para reducir cortes y mantener las actualizaciones.
-
Salida estable con alta concurrencia
Optimizado para scraping por lotes a escala. Devuelve HTML limpio listo para parsing e ingesta en base de datos.
Casos de uso
Ideal para scraping de noticias y ficción web con recolección estable en entornos con Cloudflare y otros sistemas de verificación
Agregación de noticias y deduplicación
Rastrea actualizaciones en varias fuentes, detecta duplicados y crea una línea de tiempo y base de eventos para búsqueda, recomendaciones y monitorización.
Sync incremental de catálogos y capítulos
Sigue cambios en índices y capítulos con timestamps o IDs. Soporta crawling incremental con reanudación para evitar pérdidas o duplicados.
Extracción estructurada de páginas de detalle
Extrae títulos, bloques de contenido, metadatos de autor, fecha de publicación y comentarios en un esquema estable para indexación y analítica.
Monitorización de rankings y canales
Programa scraping de páginas “Tendencias / Últimos / Recomendados / Categorías” para detectar cambios y frecuencia de actualización.
Benchmarking y tracking de republicación
Compara versiones entre sitios, identifica rutas de repost, retrasos y reescrituras para mejorar precisión y análisis de contenido.
Planificación de jobs y recuperación con reintentos
Ejecuta scraping en colas con reintentos y backfill ante fallos o bloqueos, manteniendo pipelines estables y evitando huecos de datos.
Flujo de integración
1. Crear cuenta
Registra una cuenta de Cloudbypass API: Registrarse ahora
Registra una cuenta de Cloudbypass Proxy: Registrarse ahora
Las cuentas son compartidas. Registra una sola y, en 30 días, entra al panel y haz clic en “🎁 Prueba” para recibir créditos y tráfico de prueba.
2. Generador de código
Configure y pruebe solicitudes de Cloudflare o DataDome con el generador de código. Ambos usan la misma lógica de integración y el mismo código. Mantenga la IP del proxy, las cookies y la sesión constantes.
La versión V1 incluye un pool de IP dinámicas y no requiere proxy si el acceso es correcto.
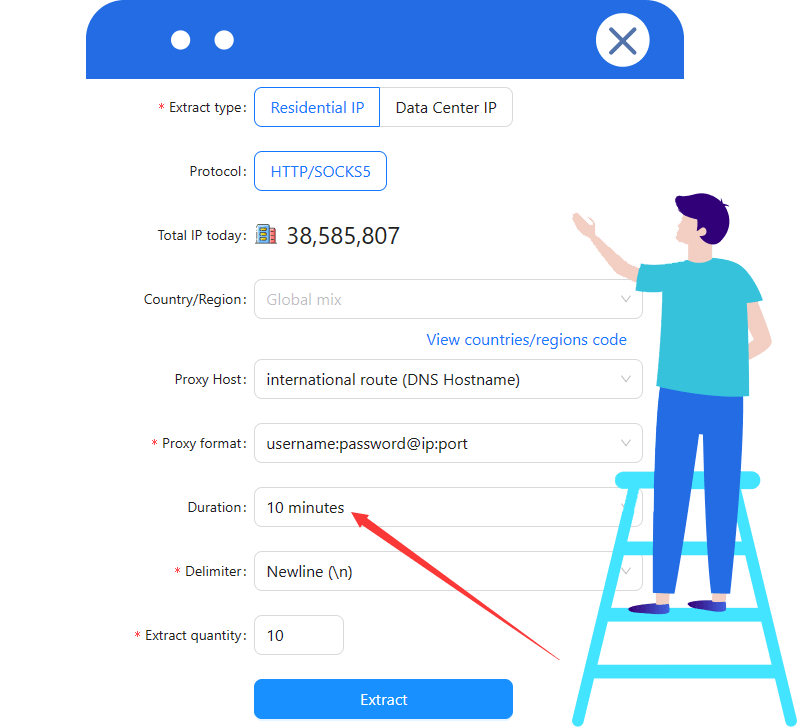
La versión V2(s) requiere IP fija o con validez temporal; para IP dinámica de Cloudbypass, configura ≥10 minutos. (ver imagen)
Para soporte técnico, revisa la documentación de la API o contacta al soporte.
3. Integrar Cloudbypass API
Integre en su aplicación el código de solicitud ya probado. Cloudflare y DataDome comparten la misma integración de API y forma de llamada. Valide el estado y el contenido antes de analizar datos, paginar o automatizar tareas.
4. Elegir plan
Una vez completadas las pruebas, elija un plan según su uso. Cloudflare y DataDome comparten los mismos créditos de API, reglas de consumo y precios. Ver precios
Para tráfico de proxy IP: 【Proxies de centro de datos dinámicos o residenciales dinámicos】
Las verificaciones de Cloudflare y DataDome consumen créditos de API; algunos flujos también requieren un proxy. Los créditos y el tráfico de proxy se facturan por separado. Un proxy no sustituye la gestión de CAPTCHA.

Precios de Cloudbypass API
Prueba la compatibilidad del sitio y elige un plan de API según tu uso
Cada solicitud correcta consume 1 crédito. Una verificación V2(s) completada consume 2 más, que no se devuelven si la respuesta posterior falla. El tráfico de proxy se factura aparte.
Plan Básico
-
$49
-
Puntos:80000Validez:30 díasParalelo:20 req/s
Plan Estándar
-
$79
-
Puntos:300000Validez:30 díasParalelo:20 req/s
Plan Avanzado
-
$129
-
Puntos:1000000Validez:30 díasParalelo:25 req/s
Plan Profesional
-
$259
-
Puntos:2200000Validez:30 díasParalelo:25 req/s
Plan Premium
-
$489
-
Puntos:4600000Validez:30 díasParalelo:30 req/s
-
Gran relación calidad-precio
Plan Enterprise
-
$1056
-
Puntos:12000000Validez:30 díasParalelo:30 req/s
Si tu volumen de scraping es mayor o necesitas un plan a medida Puntos ilimitados / Servidor dedicado / Más capacidad de concurrencia / Soporte técnico prioritario
Contactar para un plan personalizado Comprar IPs dinámicasFAQPreguntas frecuentes
¿Por qué los scrapers de noticias/ficción suelen quedarse en la verificación de Cloudflare?
Los sitios de noticias y ficción suelen activar protecciones de Cloudflare como el chequeo de 5 segundos, el JS Challenge y Turnstile CAPTCHA. Estas defensas son sensibles a solicitudes en alta frecuencia y por lotes, lo que dispara desafíos y bloqueos y rompe el pipeline de web scraping.
¿Qué tipos de desafíos de Cloudflare puede gestionar Cloudbypass API?
Soporta flujos comunes de verificación de Cloudflare, como el chequeo de 5 segundos (JS Challenge) y Turnstile CAPTCHA. La API completa el proceso de desbloqueo de forma automática y devuelve el contenido de la página para parsear, con mucha menos lógica a medida en tu scraper.
Tras integrar Cloudbypass API, ¿en qué formato se devuelven los resultados?
Si la solicitud tiene éxito, suele devolver el código fuente (HTML) de la página objetivo. Así puedes extraer el contenido, parsear capítulos, deduplicar y guardar en tu backend.
¿Cómo se mantiene la estabilidad en web scraping de noticias/ficción con alta concurrencia?
Cloudbypass API está diseñada para scraping por lotes y soporta alta concurrencia para reducir picos de fallos por verificación. Para crawlers de larga duración, recomendamos cola de tareas, reintentos y actualizaciones incrementales para mantener los refrescos continuos.
Al rastrear capítulos, ¿cómo evitar perder o duplicar actualizaciones?
Usa “número de capítulo / hora de actualización” como clave incremental y guarda checkpoints. Si una solicitud se bloquea o falla, reinténtala desde la cola con una estrategia de reintentos para mantener completa la cadena catálogo→capítulo.
¿Para qué flujos de web scraping funciona mejor Cloudbypass API?
Funciona bien en flujos estructurados como listas de categorías, páginas de temas, detalle de artículos, tablas de contenido, paginación de capítulos y feeds de actualización, sobre todo cuando Cloudflare provoca redirecciones de verificación y límites de solicitudes.